Bài dịch: Luận về độ mạnh của các định lý - Terence Tao
Dịch từ nguyên tác On the Strength of Theorems của Terence Tao (giáo sư toán học tại UCLA), đăng trên blog What's New (terrytao.wordpress.com) ngày 29/7/2014. Bài viết từng được đăng lần đầu trên Google Buzz ngày 5/9/2010.
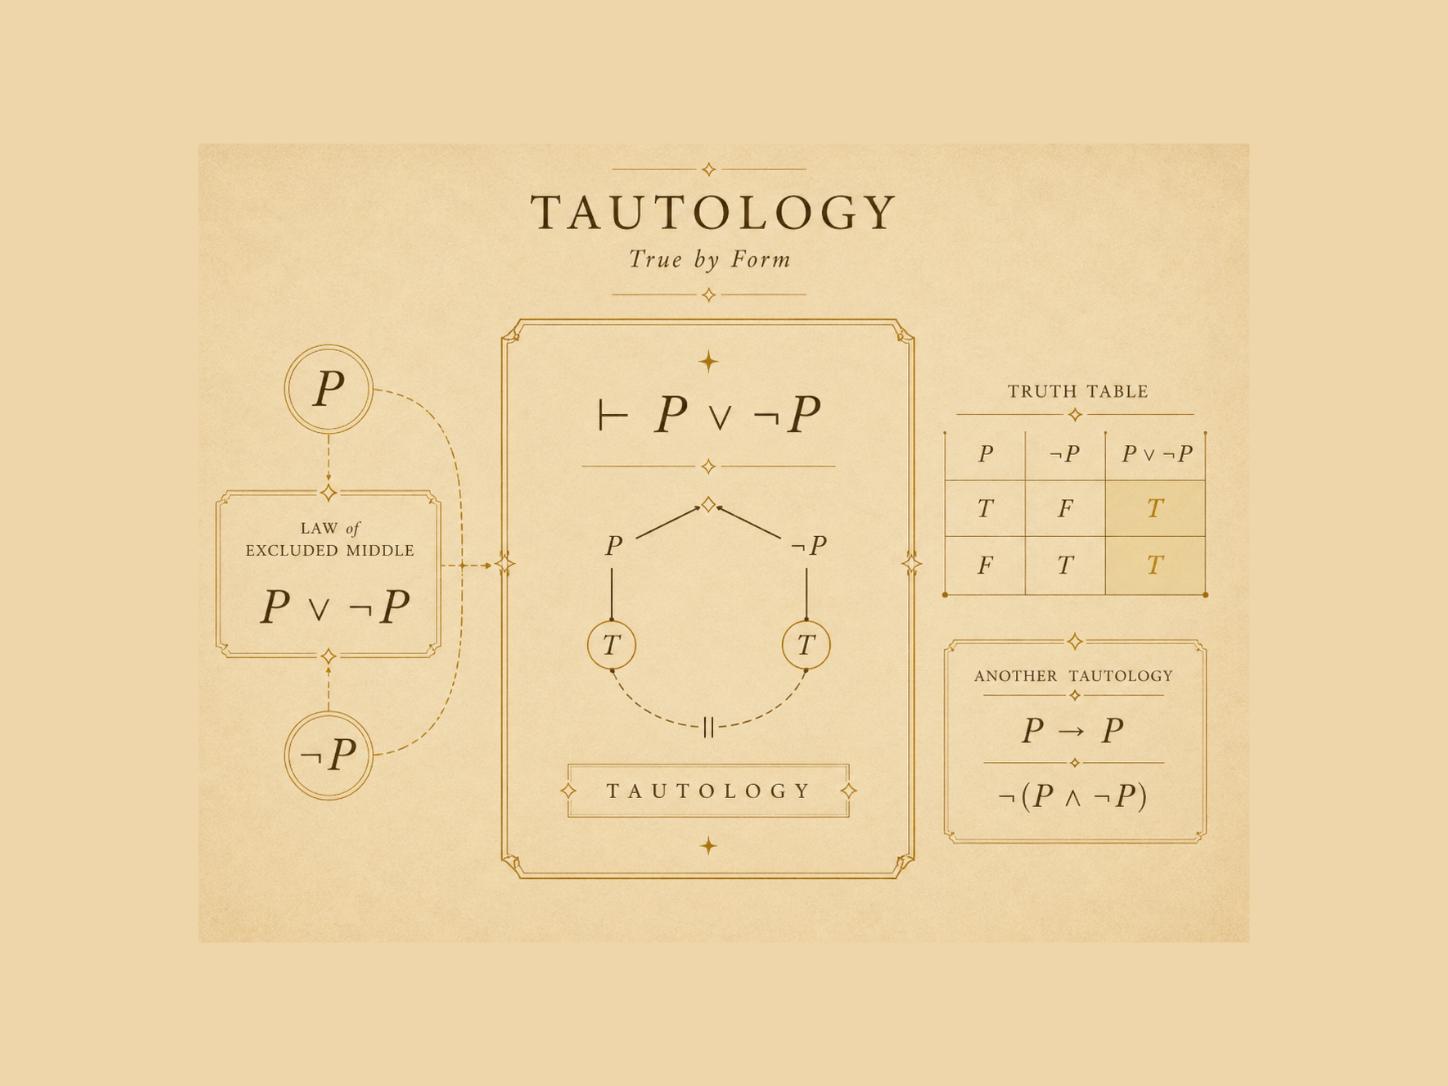
Nhà triết học đầu thế kỷ 20, Ludwig Wittgenstein, từng đưa ra một quan điểm nổi tiếng rằng mọi định lý toán học [đều] là một câu lặp thừa1 và do đó tất các định lý như vậy chứa đựng một lượng nội dung tầm thường (trivial). Quan điểm này có một phần chân lý trong đó; khi một bài toán khó cuối cùng cũng được giải quyết, giải pháp đó thường khiến bài toán ban đầu trông dễ dàng hơn đáng kể so với những gì người ta từng nghĩ trước đây. Quả thực, người ta có thể đưa ra một góc nhìn đi ngược với trực giác cho rằng tiến bộ trong toán học có thể đo lường bằng việc có bao nhiều phần của toán học đã trở nên tầm thường (hoặc ít nhất là dễ hiểu hơn so với trước đó).
Mặt khác, rõ ràng là có những định lý toán học “mạnh hơn” các định lý khác, ngay cả khi dưới góc nhìn logic thuần túy, tất cả chúng đều “chỉ” là các câu lặp thừa. Chẳng hạn, một định lý có thể được coi là mạnh vì các kết luận của nó mạnh, vì các giả thiết của nó (hay hệ tiên đề được dùng trong phép chứng minh) yếu, hoặc do sự kết hợp của cả hai lý do trên.
Tổng quát hơn, điều gì làm nên độ mạnh của một định lý? Đây không phải là một khái niệm chính xác hay được định nghĩa tốt. Nhưng có một cách để đo lường được độ mạnh của một định lý là kiểm tra nó trước một lớp các câu hỏi và bài toán mà định lý đó được dùng để hỗ trợ việc giải quyết [vấn đề]. Ví dụ, người ta có thể đánh giá độ mạnh của một định lý trong lý thuyết số giải tích thông qua độ lớn của sai số mà nó mang lại cho các đại lượng lý thuyết số khác nhau; tương tự, người ta có thể đánh giá độ mạnh của một định lý trong phương trình đạo hàm riêng/phương trình vi phân riêng phần (PDE) dựa trên độ lớn của lớp dữ liệu ban đầu mà định lý có thể áp dụng, và mức độ kiểm soát thu được đối với nghiệm của phương trình như một hệ quả; và cứ tiếp tục như vậy.
Nếu các yếu tố khác đều như nhau, những phát biểu phổ quát2 như "P(x) đúng với mọi x" thường mạnh hơn các phát biểu tồn tại3 như "P(x) đúng với một vài x", tất nhiên là với giả định rằng ta đang lượng hóa trên một không gian không-rỗng. Cũng có những phát biểu mang độ mạnh trung bình, chẳng hạn như "P(x) đúng với nhiều x", hoặc "P(x) đúng với hầu hết mọi x". Tương tự, những phát biểu về các loại đối tượng đặc biệt (ví dụ: các hàm đặc biệt) thường không mạnh bằng những phát biểu tương tự về các loại đối tượng tổng quát (ví dụ: các hàm tùy biến trong một không gian hàm cho trước), cũng với giả định rằng mọi yếu tố khác là như nhau. (Trong thực tế, thường có sự đánh đổi: để đạt được các phát biểu tổng quát hơn, người ta phải làm yếu đi kết luận, do đó không có kết quả nào trở nên mạnh hơn một cách rõ rệt so với kết quả còn lại).
Các phát biểu tiệm cận4 (ví dụ: các phát biểu chỉ mang nội dung khi một tham số nào đó, chẳng hạn như N là "đủ lớn", hoặc trong giới hạn N→∞) thường không mạnh bằng các phát biểu phi tiệm cận (những phát biểu mang nội dung với mọi lựa chọn tham số N cố định). Một lần nữa, điều này giả định rằng mọi yếu tố khác là như nhau. Tương tự, các phát biểu xấp xỉ (ví dụ: các đánh giá/ước lượng) không mạnh bằng các phát biểu chính xác, nếu tất cả các yếu tố khác đều như nhau.
Các phát biểu về những đối tượng "dễ" hoặc đã được hiểu rõ thường không mạnh bằng các phát biểu về những đối tượng "khó" hoặc chưa được hiểu rõ. Chẳng hạn, các phát biểu về nghiệm của phương trình trên tập số thực có xu hướng yếu hơn đáng kể (và dễ chứng minh hơn) so với các phát biểu tương ứng về phương trình trên tập số nguyên; tương tự, các kết quả về toán tử tuyến tính yếu hơn các kết quả tương ứng về toán tử phi tuyến tính; các phát biểu liên quan đến các hàm số học có sự nhạy bén với phân tích thừa số nguyên tố (như hàm Möbius hay hàm von Mangoldt) thường mạnh hơn các phát biểu tương tự về các hàm không số học (như hàm lôgarit); và cứ tiếp tục như vậy.
Khi cố gắng đọc và hiểu một phép chứng minh dài và phức tạp, một việc hữu ích nên làm là nhìn vào độ mạnh của các phát biểu then chốt khác nhau bên trong lập luận, và tập trung vào những phần lập luận mà ở đó độ mạnh của các phát biểu tăng lên một cách đáng kể (chẳng hạn, nếu các phát biểu trước đó chỉ đúng với một giá trị của N, giờ đây lại được khuếch đại để đúng với nhiều giá trị của N). Những sự khuếch đại như vậy thường chứa đựng một thủ thuật hoặc ý tưởng cốt lõi làm động lực cho toàn bộ lập luận, và việc hiểu được những bước quyết định này thường giúp ta tiến gần hơn nhiều đến việc hiểu lập luận dưới dạng một tổng thể. (Tương tự, nếu một phép chứng minh hóa ra bị sai lầm, rất có khả năng ít nhất một trong những sai lầm đó sẽ gắn liền với một bước mà ở đó các phát biểu trở nên mạnh hơn một cách bất ngờ với một mức độ đáng ngờ, và do đó ta có thể dùng độ mạnh của các phát biểu như vậy như một cách để nhanh chóng định vị các sai lầm trong một lập luận nghi vấn).
Khái niệm về độ mạnh của một phát biểu không nhất thiết phải mang tính tuyệt đối, mà có thể phụ thuộc vào ngữ cảnh. Chẳng hạn, giả sử người ta đang cố gắng đọc một lập luận phức tạp nhằm khẳng định một phát biểu đúng trong mọi chiều d. Nếu phép chứng minh được tiến hành bằng phương pháp quy nạp theo chiều này, thì việc chấp nhận quan điểm rằng bất kỳ phát biểu nào trong chiều d+1 cũng nên được coi là "mạnh hơn" một phát biểu trong chiều d là rất hữu ích, ngay cả khi phát biểu sau thông thường sẽ được coi là mạnh hơn nếu số chiều của chúng bằng nhau. Với góc nhìn này, người ta sẽ có động lực để tập trung vào những đoạn trong lập luận mà ở đó các phát biểu trong chiều d bằng cách nào đó được chuyển đổi thành các phát biểu trong chiều d+1; những đoạn như vậy thường chính là chìa khóa để hiểu được chiến lược tổng thể của toàn bộ lập luận.
Toàn văn nguyên tác: https://terrytao.wordpress.com/advice-on-writing-papers/on-the-strength-of-theorems/.
Sắp diễn ra
Đọc tiếp
Bình luận
Chưa có bình luận, lời mở đầu vẫn để trống.